+49 89 89082-110


1,4 Millionen Dateien, ein Leak, viele offene Fragen: Die Analyse des RHYSIDA-Angriffs auf Berlin
Kennzeichnung: [OBSERVED] belegt und mit Quelle eingeordnet | [ASSESSED] fachliche Bewertung | [SCENARIO] mögliches, nicht als eingetreten belegtes Szenario.
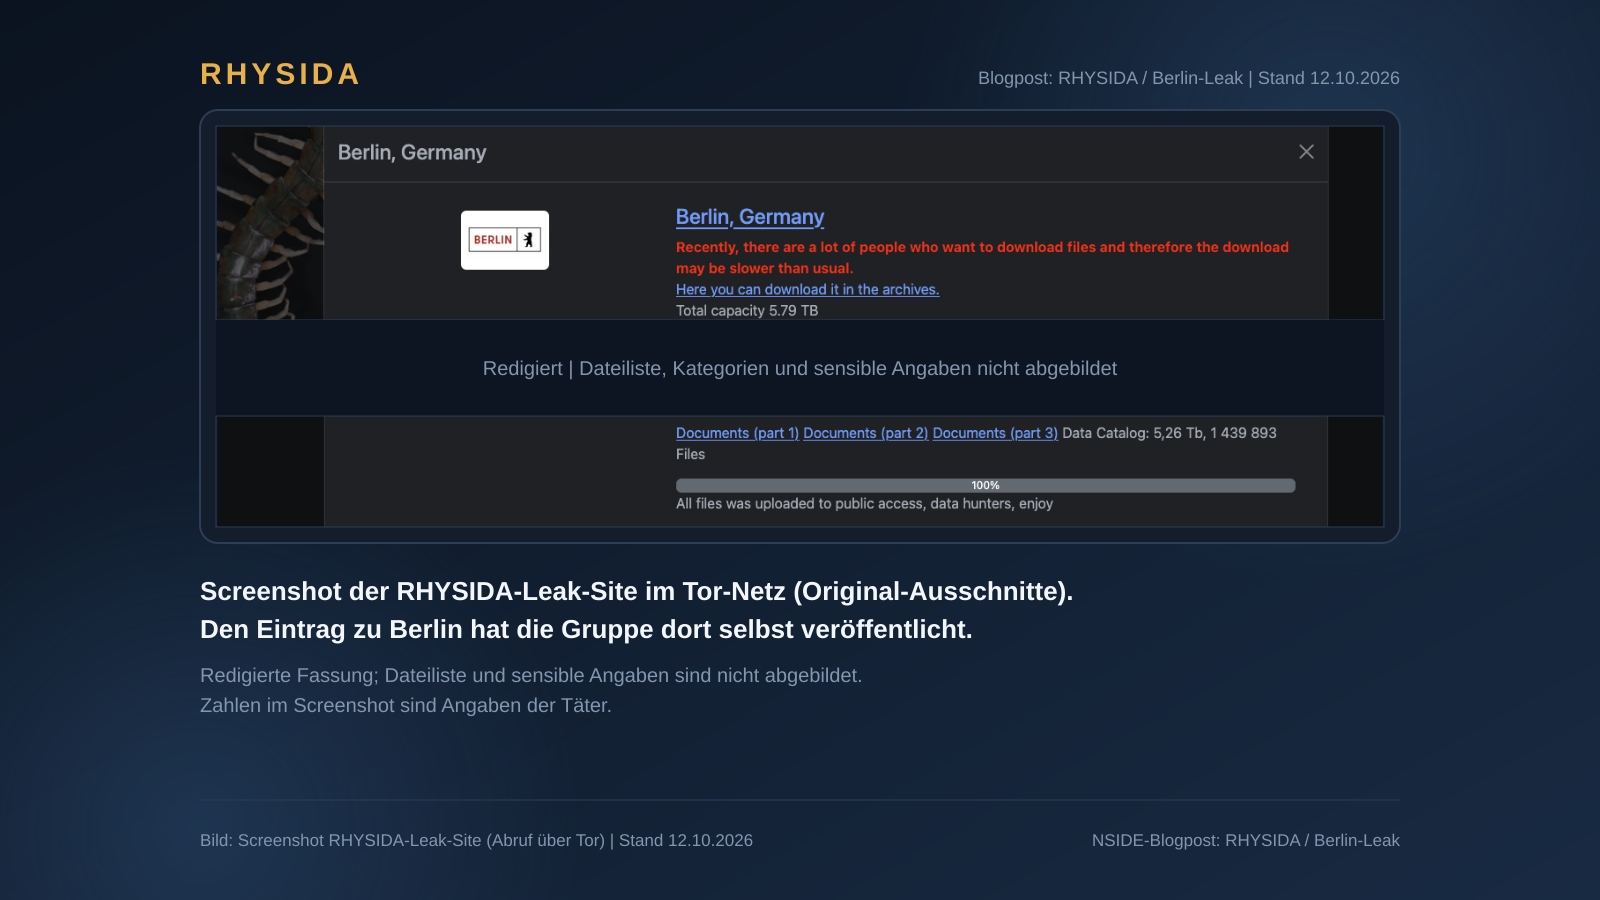
Titelbild – RHYSIDA-Leak-Site. Echte Screenshot-Ausschnitte des Eintrags „Berlin, Germany“ (Tor-Netz): Fensterkopf, Kapazitätsangabe (5,79 TB, Angaben der Täter) und Data-Catalog-Zeile (5,26 TB / 1 439 893 Dateien). Den Eintrag hat die Gruppe selbst veröffentlicht; Dateiliste und sensible Angaben sind redigiert. Abruf im Rahmen der Analyse, Stand 12.10.2026.
TL;DR
- [OBSERVED] 2026 verschaffte sich die Ransomware-Gruppe RHYSIDA Zugang zu den Netzen von zwei Berliner Senatsverwaltungen. Der genaue Zeitpunkt des Erstzugriffs ist öffentlich nicht bekannt; die Aufklärung dauert an. [1]
- [OBSERVED] Berlin datiert den wesentlichen Teil des Datenabflusses auf den 7. bis 12. August 2026. Zwei Senatsverwaltungen wurden am 14. August vorsorglich vom Landesnetz getrennt; am 4. September veröffentlichte RHYSIDA die Daten. [1][11]
- [OBSERVED] Medien berichteten über einen Erpressungsversuch mit einer Forderung von 30 Bitcoin (rund zwei Millionen Euro zum damaligen Kurs); das Land Berlin erklärte, nicht zu zahlen. [2][11][12]
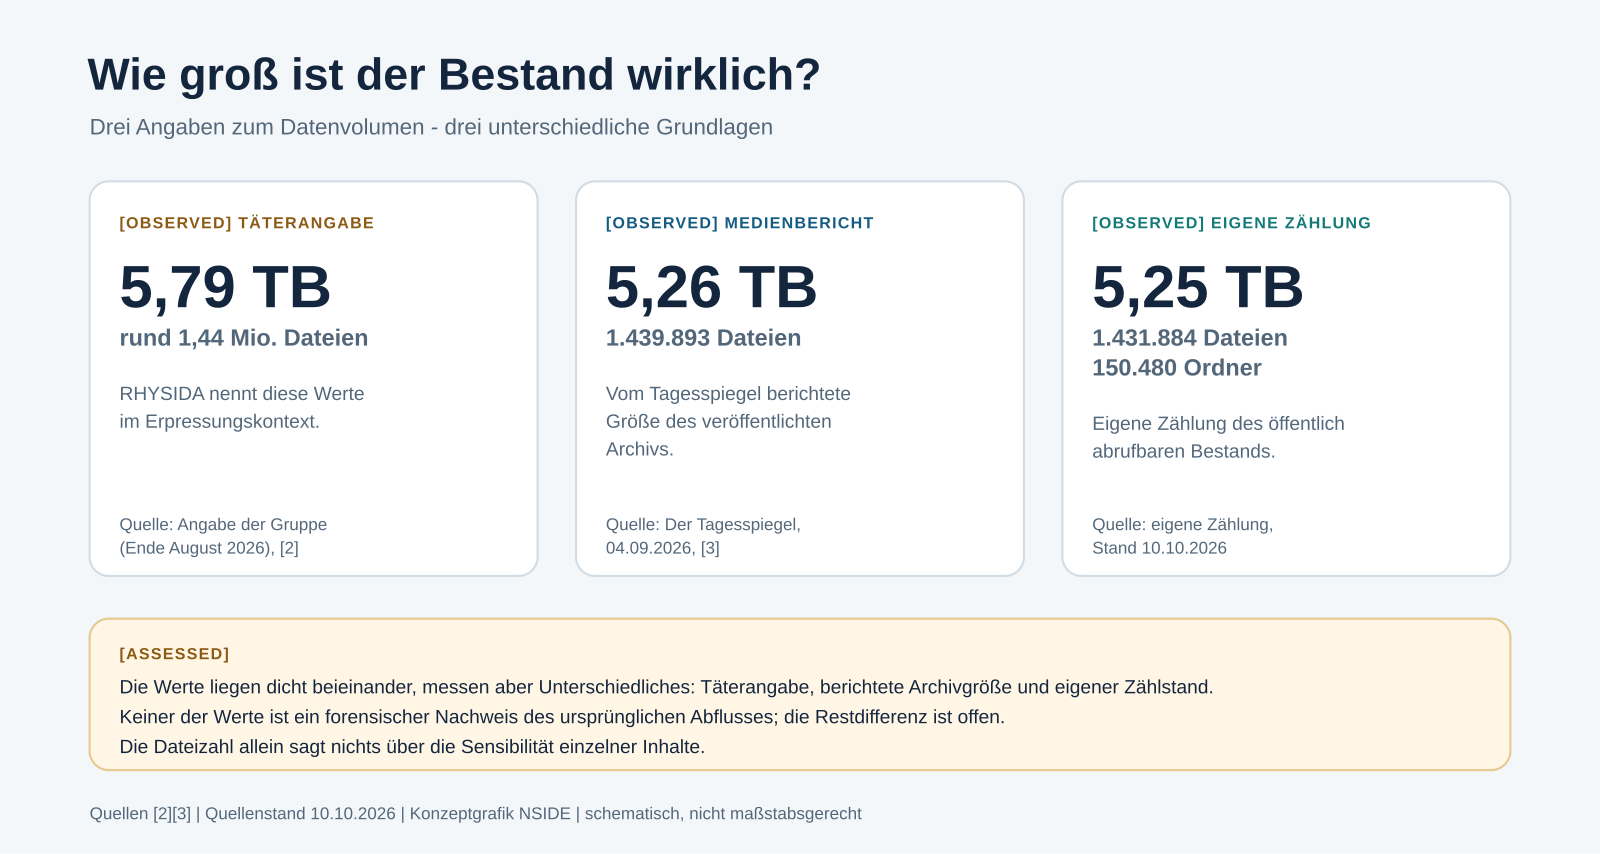
- [OBSERVED/ASSESSED] Die Datenmenge beläuft sich laut RHYSIDA auf 5,79 TB und rund 1,44 Millionen Dateien. Der Tagesspiegel berichtete über 5,26 TB und 1.439.893 Dateien. Unsere eigene Analyse zeigt 5,25 TB, 1.431.884 Dateien, 150.480 Ordner. [2][3]
- [ASSESSED] Ein Leak dieser Größe ist nicht ohne Weiteres analysierbar: Download über das Tor-Netzwerk, Bestandsaufnahme, Testläufe, dateitypbezogene Extraktion, und menschliche Qualitätssicherung sind sehr zeitaufwendig.
- [SCENARIO] Der Vorfall kann wegen Berlins Rolle als Hauptstadt und Regierungssitz kritische Folgen haben.
- [SCENARIO] Indirekt betroffene Dritte (Organisationen und Personen, die mit den Berliner Senatsverwaltungen gearbeitet haben) finden sich in den Datenmengen, was teilweise kritische Risiken für diese Entitäten bedeuten kann.
- Da auch einige unserer Kunden betroffen sind und an uns herangetreten sind, haben wir die Daten heruntergeladen und kundenspezifisch analysiert, um den Grad der Betroffenheit und das bestehende Risiko für unsere Kunden zu ermitteln.
Stand: Quellenstand 13.10.2026; Publikationsdatum 12.10.2026. Autor: NSIDE.
Hintergrund: Was öffentlich bekannt ist
Berlin, zwei Senatsverwaltungen, ein Datenabfluss: Der Fall ist in den Grundzügen öffentlich dokumentiert, die Aufarbeitung läuft. Der belegbare Stand:
[OBSERVED] Berlin bestätigt den Zugriff auf das Verwaltungsnetz und die Veröffentlichung von Daten am 4. September 2026. Nach Behördenangaben fällt der wesentliche Teil des Abflusses in den Zeitraum vom 7. bis 12. August; zwei Senatsverwaltungen wurden am 14. August vorsorglich vom Landesnetz getrennt. Betroffen seien überwiegend unstrukturierte Daten aus gemeinsam genutzten und persönlichen Verzeichnissen – die vollständige Prüfung läuft noch. [1][11]
[OBSERVED] Ende August spitzte sich der Fall öffentlich zu: RHYSIDA beanspruchte den Angriff und forderte nach übereinstimmenden Medienberichten 30 Bitcoin – zum damaligen Kurs rund zwei Millionen Euro – mit einer Frist von etwa einer Woche. Der Regierende Bürgermeister bestätigte den Erpressungsversuch und ließ erklären, das Land Berlin werde sich nicht erpressen lassen. Gezahlt wurde nicht; Anfang September wurde das Archiv im Darknet veröffentlicht. [2][11][12]
[OBSERVED] In der Nacht zum 6. September veröffentlichte die Gruppe nach Angaben des Senats ein weiteres Datenpaket; Medien berichteten, darunter seien unter anderem Zugangsdaten. [14]
[OBSERVED/ASSESSED] Die Datenmenge beläuft sich laut RHYSIDA auf 5,79 TB und rund 1,44 Millionen Dateien. Der Tagesspiegel berichtete über 5,26 TB und 1.439.893 Dateien. Unsere eigene Analyse zeigt 5,25 TB, 1.431.884 Dateien, 150.480 Ordner. [2][3] Wie sich die verbleibenden Unterschiede zwischen Angabe, Medienbericht und eigener Zählung erklären lassen, ist noch offen.
[OBSERVED] Auch die öffentlichen Zeitangaben sind nicht deckungsgleich. Berlin datiert den wesentlichen Datenabfluss auf den 7. bis 12. August. The Hacker News berichtete am 28. August unter Berufung auf eine Auskunft der Senatskanzlei, die betroffene Verwaltung habe bereits am 7. August einen Datenabfluss gemeldet; ein Berlin.de/dpa-Bericht beschreibt den Angriff als am 14. August festgestellt. Wie diese Meldung, die Feststellung des Angriffs und die spätere Netztrennung zusammenhängen, erklären die Quellen nicht im Detail. [1][2][10][11]
[ASSESSED] Der zeitliche Abstand ist bemerkenswert – belegt aber weder sieben Tage unbemerkten Zugriff noch ein bestimmtes Versäumnis. Öffentlich ist nicht dokumentiert, was wann verifiziert, eskaliert oder entschieden wurde. Das offizielle Abflussfenster ist zudem kein belegter Eindringzeitpunkt: Datei-Zeitstempel allein würden den Zeitpunkt einer Kopie nicht nachweisen, und ein unabhängiger Abgleich ist bislang nicht erfolgt.
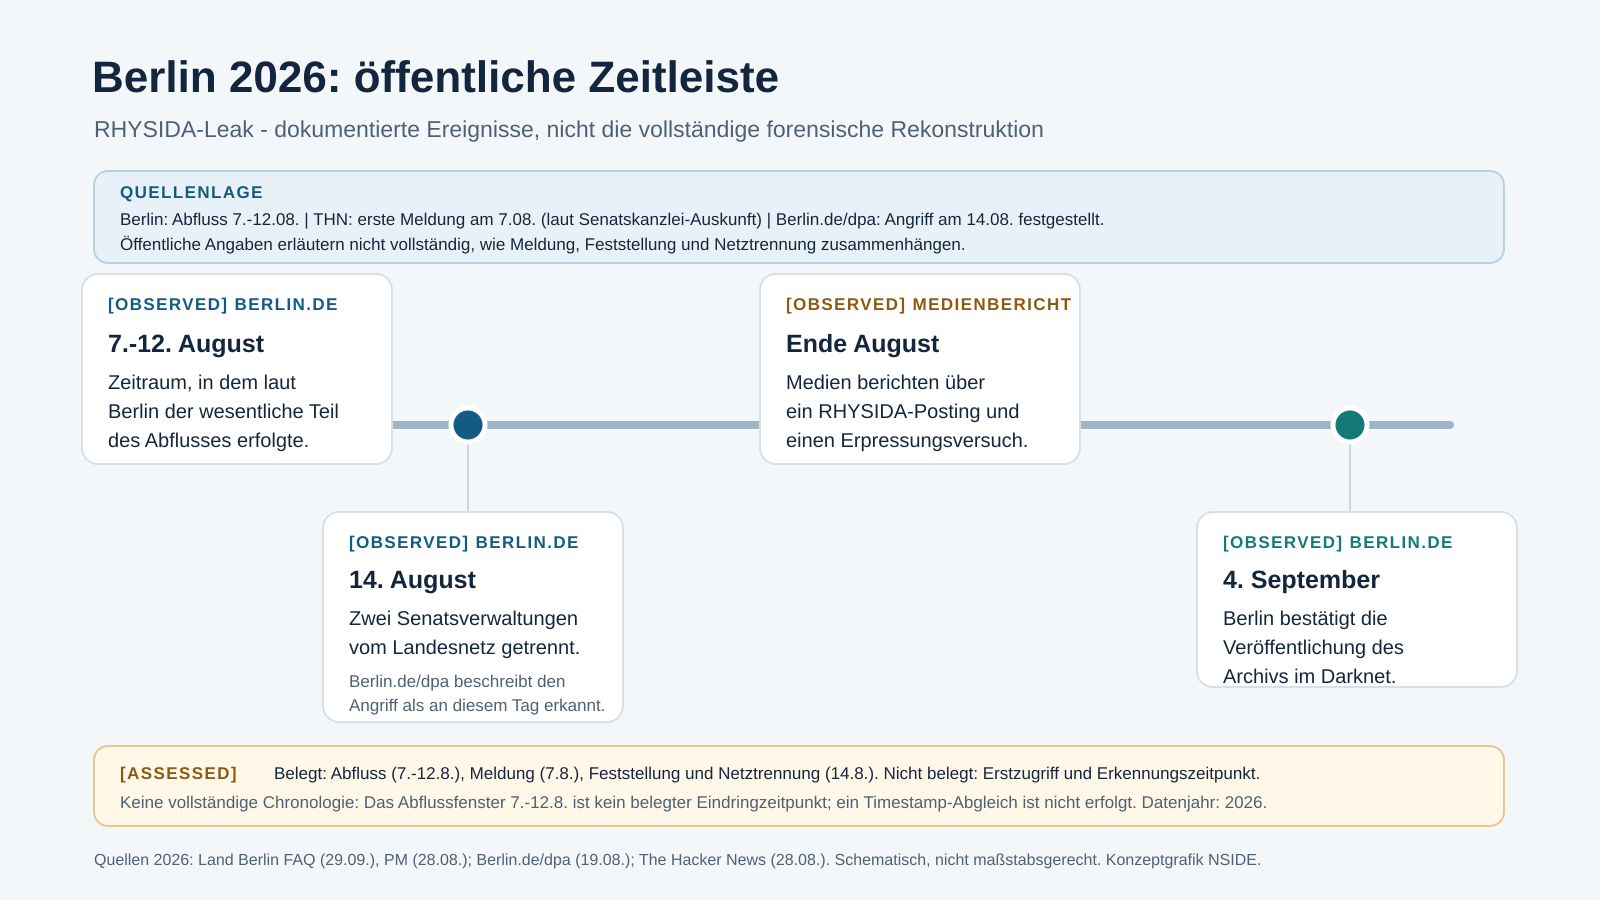
Abbildung 1 – Zeitlinie. Trennt die am 7. August berichtete Datenabflussmeldung vom offiziellen Abflussfenster (7. bis 12. August), der Feststellung des Angriffs am 14. August und der Veröffentlichung am 4. September. Die öffentlichen Quellen erläutern den Zusammenhang nicht vollständig. [1][2][10][11]
Schritt 1 – Download: Der lange Weg durch Tor
Zwischen „die Gruppe hat veröffentlicht“ und „wir können den Bestand auswerten“ liegt ein Problem, das man leicht unterschätzt, wenn Leak-Daten in Terabyte-Größe ausschließlich über das Tor-Netzwerk bereitgestellt werden – auf einer Infrastruktur, die für langsame, instabile Verbindungen bekannt ist. Ein naiver Download scheitert an der schieren Größe: Verbindungen brechen ab, und einfache Werkzeuge fangen nach jedem Abbruch wieder bei null an. Bei mehreren Terabyte und mehr als einer Million Dateien ist das kein Ärgernis, sondern ein eigenes Projekt.
[ASSESSED] Wer einen solchen Bestand auswerten will, braucht deshalb zuerst ein Downloadverfahren, das Abbrüche übersteht und jeden Download nachvollziehbar macht. Der Unterschied zwischen „hat irgendwie geklappt“ und einer tragfähigen Grundlage ist der Vollständigkeitsnachweis, trotz wechselnder Download-Mechaniken auf dem RHYSIDA-Server: dieselbe Datei, dieselbe Größe, derselbe Hash.
[ASSESSED] Genau dafür haben wir bei NSIDE einen eigenen Tor-Downloader gebaut. Downloads werden über große Containerfarmen intelligent abgearbeitet und harmonisiert. Der Crawler unterscheidet Verbindungsprobleme im Tor-Netz von Ausfällen des RHYSIDA-Hidden-Service und wartet bei bestätigten Störungen mit wachsendem Abstand, statt ins Leere zu laufen – danach setzt er exakt an der letzten Position fort. Auch die mehrfach gewechselten Download-Mechaniken (Dateibäume vs. TGZ-Container) berücksichtigt er automatisch. Ein Ledger in einer SQLite Datenbank hält den Status jeder Datei fest, um nie den Faden zu verlieren und jederzeit den Zustand zu kennen in dem sich die Downloads befinden. Angesichts häufiger Ausfälle der RHYSIDA-Server, sehr hoher Nachfrage nach den Dateien, begrenzter Bandbreite pro Nutzer und des langsamen Tor-Netzes hätte ein herkömmlicher Download Monate gedauert. Unser Downloader schloss den Download in rund zweieinhalb Wochen ab.
Schritt 2 – Erste Sichtungen: Was im Datenbestand steckt – und was das für Betroffene bedeutet
Vor der automatisierten Auswertung haben wir bewusst selbst in den Bestand geschaut – Stichproben statt Vorannahmen. Was wir dort sahen, war ernüchternd.
Zuerst aber:
[OBSERVED] Was die Senatsverwaltungen selbst bekannt gaben: Berlin beschreibt die abgeflossenen Bestände als überwiegend unstrukturierte Daten aus gemeinsam genutzten und persönlichen Verzeichnissen – nicht als Auszug aus spezialisierten Fachanwendungen. Personenbezogene Daten von Beschäftigten, Bürgerinnen und Bürgern sowie von Unternehmen können darunter sein; die vollständige Prüfung dauert an. Die Berliner Datenschutzaufsicht betont zugleich: Eine pauschale Täter- oder Medienangabe belegt keine individuelle Betroffenheit. Entscheidend ist die belastbare Einzelfallprüfung – nicht die Schlagzeile. [1][4]
[OBSERVED – eigene Sichtung] Was wir gesehen haben:
Hinweis zum Datenschutz: Wir zeigen keine Einzelfunde, keine Namen und keine Trefferbeispiele, denn schon Dateinamen, Betreffzeilen, Zeitstempel oder die Kombination weniger Merkmale können Rückschlüsse auf Betroffene erlauben.
Wir fanden unter anderem:
- Planungsunterlagen zu kritischen Infrastrukturen – darunter Regierungsgebäude sowie Einrichtungen der Energie- und Wasserversorgung (ohne Nennung konkreter Objekte)
- Mehr als fünf Millionen E-Mail-Nachrichten aus den Jahren 1999-2026, inklusive Anhängen (.pst, .ost, .msg, .eml u. a.)
- Teilnehmerlisten und Details zu als GEHEIM eingestuften Veranstaltungen
- Hunderte Zugangsdaten zu internen und externen Systemen
- Ausführliche Dokumentation über die IT-Infrastruktur der Senatsverwaltungen
- Personalakten mit diversen Details zu Personen
- Juristische Akten und Details zu Gerichtsprozessen
- Umfangreiche Einblicke in interne Verfahren und Prozesse mit Bezügen zu weiteren Behörden
- und vieles mehr.
Schritt 3: Automatisierte Analyse-Pipeline zur zweckgebundenen Prüfung betroffener Kunden
Analysen wie diese werden nicht aus Neugier gemacht, sondern zweckgebunden, um für unsere Kunden kritische Fragen zu beantworten: Sind wir betroffen, und wenn ja, wo? Weil es dabei um personenbezogene Daten geht, läuft unsere Analyse-Pipeline vollständig lokal: Eine Cloud-Auswertung der Daten findet nicht statt.
Unsere rhysida-analyzer-Pipeline leistet im Wesentlichen Folgendes:
- Inventar und Extraktion: Aus dem Rohbestand entstehen auswertbare Inhalte – Archive, Office-Dokumente, PDFs, Bilder (OCR), Datenbankabzüge. Dateien werden im Standardablauf gelesen, nicht ausgeführt.
- Regeln und Priorisierung: Den Regelkatalog erstellen wir gemeinsam mit dem jeweiligen Kunden. Ein erster Durchlauf markiert alle Dateien, die einem Erwähnungsmuster entsprechen; ein zweiter durchsucht diese Treffer nach zuvor definierten Relevanzmustern – etwa Personenbezug, Klassifizierung, Zugangsdaten oder Vertragsbezüge – und priorisiert sie für die weitere Prüfung.
- E-Mail-Bestände: Unterstützte Postfachformate werden nachrichtenweise verarbeitet; Anhänge und Verläufe lassen sich so im Kontext einordnen und ebenfalls nach Regeln/Mustern durchsuchen und priorisieren.
- Lokale Zweitmeinung: Eine erste, automatisierte Bewertung durch ein lokales Sprachmodell (LLM) unterstützt die Priorisierung und erleichtert es einem Sichter auf Kundenseite die vielen Treffer auszuwerten.
Ein Nichttreffer bei Relevanzmustern bleibt trotzdem ein offener Punkt, kein Beleg für Abwesenheit; OCR-Abdeckung und Spezialformate sind eigene Arbeitsschritte. Unser Tool weist übersprungene oder nicht ausgewertete Daten gesondert aus: ausgeschlossene Formate, Extraktionsfehler, unvollständige OCR-Abdeckung, Dubletten und False Positives.
Masse ersetzt keine Klasse: Ein Bestand dieser Größe wird nicht dadurch beherrschbar, dass man alles scannt, sondern dadurch, dass man richtig priorisiert, Kontext einbezieht und am Ende jede Aussage belegen kann. Das ist der Unterschied zwischen einer Datenhalde und einer professionellen Datenanalyse, die Betroffenen wirklich hilft.
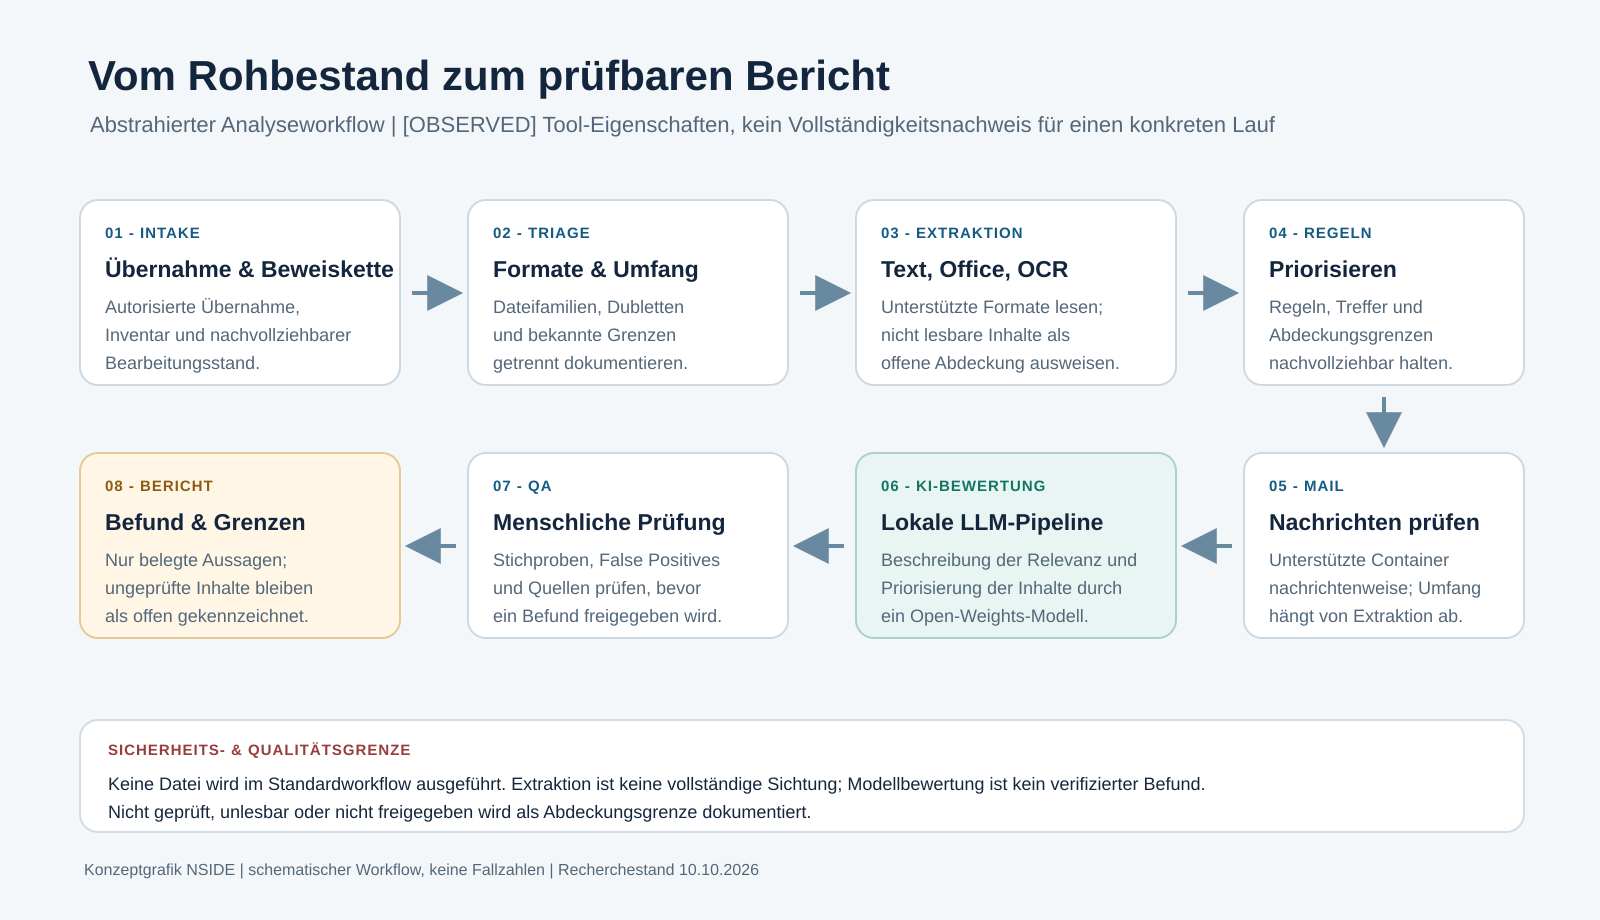
Abbildung 3 – Analyse-Workflow. Übernahme mit Beweiskette > Format-Triage > Extraktion & OCR > Regeln > Mail-Prüfung > optionale lokale Zweitmeinung > menschliche QA > Bericht mit Abdeckungsgrenzen. Nicht extrahierte Inhalte bleiben als offene Abdeckung sichtbar, nicht als Negativbefund.
Schritt 4: Report-Generierung
Nach der Analyse entsteht ein strukturierter HTML-Report: eine Tabelle mit Risiko-Priorisierung, Sortier- und Filteroptionen und allen Details, die der Sichter auf Kundenseite braucht. Da alle Analysedaten strukturiert als JSON vorliegen, lässt sich das Format flexibel anpassen.
TI-Einschätzung: RHYSIDA, Berlin und die Bundesdimension
[OBSERVED] RHYSIDA wird von CISA, FBI und MS-ISAC in einem gemeinsamen Advisory als Ransomware-as-a-Service-Operation beschrieben: Werkzeuge und Infrastruktur werden im Profit-Sharing-Modell verliehen, Datenexfiltration und Erpressung gehören zu den dokumentierten Gruppenmustern. Als Zielrichtungen nennt das Advisory seit Mai 2023 überwiegend Bildung, Gesundheitswesen, produzierendes Gewerbe, IT und Verwaltung – „targets of opportunity“. Als beobachtete Erstzugänge nennt es unter anderem kompromittierte gültige Zugangsdaten an externen VPN-Zugängen. [5]
[OBSERVED – Medienbericht] Nach einem Bericht von heise online (07.09.2026) hat das BSI bestätigt, dass die Angreifer über die TerminalFix-Methode in die Netze des Berliner Senats gelangten – eine Variante der ClickFix-Kampagne (gefälschtes Captcha, PowerShell-Befehl). Die BSI-Sicherheitsmitteilung selbst beschreibt die Kompromittierung einer staatlichen Institution, ohne Berlin zu nennen. [13]
[OBSERVED] Zur Täterschaft im Berlin-Fall sagt Berlin selbst bislang: krimineller Angriff. Eine technische Bestätigung der Attribution enthält die geprüfte FAQ nicht. Eine Senatssprecherin wurde am 1. September mit der Aussage zitiert, es gebe keine Erkenntnisse über Verbindungen nach Russland oder zum russischen Staat – ausschließen könne man sie nicht. Das BSI führt RHYSIDA in seinem Gruppenüberblick im Kontext des kriminellen Akteurs Vice Spider (Namensgebung durch CrowdStrike); eine staatliche Zuschreibung ist damit nicht verbunden. [1][2][6][9]
[ASSESSED] In den geprüften öffentlichen Quellen findet sich kein Beleg für einen russischen Staatsauftrag oder eine direkte staatliche Steuerung des Angriffs. Sprach- und Infrastrukturhinweise allein tragen eine solche Zuschreibung nicht. Umgekehrt bleibt es ein eigenes Szenario, wenn veröffentlichte Informationen später von staatlichen oder anderen Akteuren genutzt würden – über die Urheberschaft des Angriffs sagt das nichts.
Warum der Vorfall nicht nur eine Landesangelegenheit ist
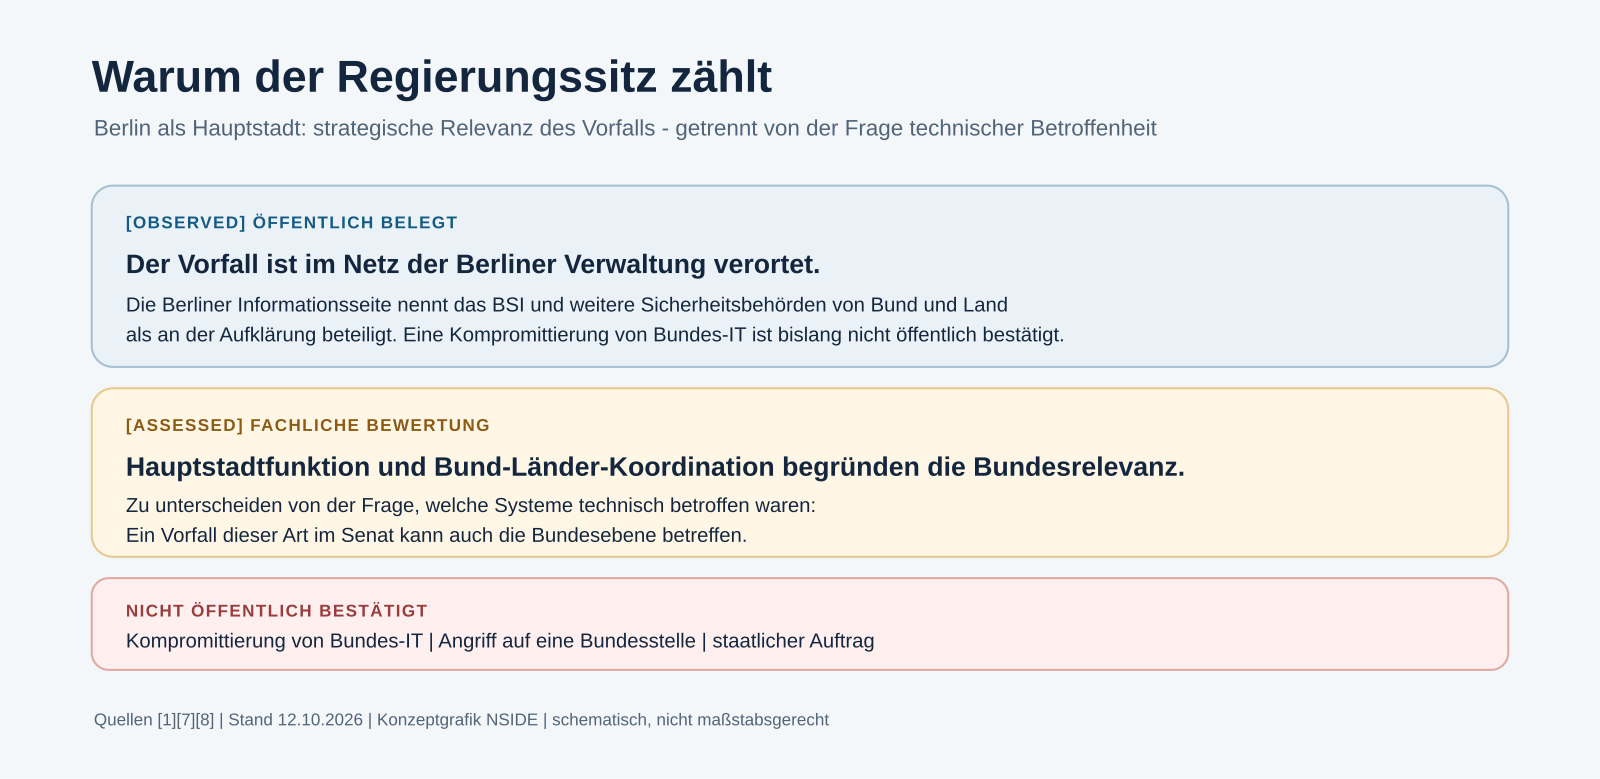
[OBSERVED] Berlin ist Hauptstadt und Regierungssitz; hier laufen zentrale Regierungsfunktionen zusammen. Die Berliner Informationsseite nennt das BSI und weitere Sicherheitsbehörden von Bund und Land als an der Aufklärung beteiligt. Eine Kompromittierung von Bundes-IT ist bislang nicht öffentlich bestätigt. [1][7][8]
[ASSESSED] Ein Vorfall dieser Art im Senat kann auch die Bundesebene betreffen. Der Vorfall ist wegen Hauptstadtfunktion und Bund-Länder-Koordination strategisch bundesrelevant – zu unterscheiden von der Frage, welche Systeme technisch betroffen waren.
[OBSERVED – eigene Sichtung] In den bislang gesichteten Daten finden sich unter anderem Bauunterlagen zu Gebäuden von Bundesbehörden und Kontaktdaten von Beschäftigten – Inhalte, die für Angreifer von Interesse sein dürften. Die nächsten Wochen und Monate werden zeigen, welche weiteren kritischen Informationen des Bundes betroffen sind.
[SCENARIO] Da in dem Leak Kontakte, E-Mail-Konversationen und Abläufe mit Bundesstellen und anderen Partnern vorliegen, könnten Bedrohungsakteure und Kriminelle sie für gezielte Phishing- oder Betrugsversuche nutzen. Belegt ist eine solche Folgeoperation bislang nicht. Nach unserer Sichtung bieten die vorliegenden Informationen eine breite Grundlage für gezielte Kampagnen – etwa Spear-Phishing gegen Bundesbehörden und weitere Organisationen.
[SCENARIO] Da es um ein Datenleak der Hauptstadtverwaltung eines G7 Mitglieds geht, werden sich mit sehr hoher Wahrscheinlichkeit (Confidence HIGH) chinesische, russische und anderen Nachrichtendienste auch um den Datenbestand bemühen. Zum Beispiel: E-Mails mit Kontext OPLAN DEU, die offenlegen welche Stellen und Personen daran mitarbeiten, könnten in Zukunft einzeln oder in Gruppen gezielt von fremden Nachrichtendiensten digital oder in der realen Welt angegangen werden. Die Masse an offenen bzw. nun geleakten aber VS-eingestuften Informationen lässt für Nachrichtendienste Rückschlüsse auf VS-VERTRAULICH oder GEHEIM eingestuften Daten, die NICHT im Leak enthalten sind, zu!
[SCENARIO] Zudem konnten wir diverse Zugangsdaten zu extern, aus dem Internet erreichbaren Diensten von anderen Organisationen und Unternehmen identifizieren. Nach unserer Einschätzung ist ein Teil dieser Zugänge weiterhin nutzbar. Es ist davon auszugehen, dass Angreifer sie testen – Folgekompromittierungen bei den betroffenen Organisationen sind möglich.
Ausblick: Wochen, Monate, Jahre
[OBSERVED] Die Berliner Informationsseite warnt vor unaufgeforderten Hilfsangeboten – etwa Angeboten, eine Betroffenheit zu prüfen oder Daten aus dem Darknet zu löschen. Sie empfiehlt, die Echtheit solcher Kontaktaufnahmen über offizielle Wege zu prüfen. [1]
[SCENARIO] In den ersten Wochen könnten veröffentlichte Kontaktdaten und Verwaltungsbezüge für glaubwürdig wirkende Phishing- und Betrugsversuche genutzt werden – solche Wellen wären typisch. Belegt ist bislang der Warnhinweis, nicht eine konkrete Kampagne.
[SCENARIO] In den kommenden Monaten könnten die Daten als Rohstoff für Folge-Intrusionen und weitere Erpressungsversuche dienen; zugleich dürfte der Fall die Debatte über Segmentierung und den Betrieb gemeinsamer Verwaltungsnetze befeuern. Verbindliche Maßnahmen oder deren Zeitplan sind nicht absehbar.
[SCENARIO] Über Jahre gedacht bleibt ein veröffentlichter Bestand dauerhaft verfügbar: kopierbar, neu sortierbar, mit anderen Quellen verknüpfbar. Identitätsmissbrauch, gezielte OSINT-Auswertung und Vertrauensschäden sind die plausibelsten Langfristfolgen. Eine Veröffentlichung lässt sich nicht zurückholen – nur der Umgang damit gestalten.
[ASSESSED] Die Reaktion gehört auf zwei Spuren geführt: technische Eindämmung und Wiederherstellung auf der einen, Bewertung der offengelegten Daten und Kommunikation auf der anderen Seite. Ein gemeinsames Entscheidungsprotokoll hält fest, welche Maßnahme auf welchem verifizierten Hinweis beruht, wer verantwortlich ist und wann neu bewertet wird. So werden bestätigte Risiken priorisiert, ohne ungesichtete Daten pauschal als kompromittiert oder unbedenklich einzustufen.
[ASSESSED – Empfehlungen auf einen Blick]
- Offizielle Informations- und Kontaktkanäle nutzen; unaufgeforderte „Darknet-Löschhilfen“ ignorieren.
- Bei konkreten Hinweisen auf offengelegte Zugangsdaten: betroffene Konten, Schlüssel und Tokens priorisiert widerrufen oder erneuern – aber nicht pauschal behaupten, jeder Zugang sei betroffen.
- Mehr-Faktor-Authentisierung (MFA) durchsetzen, besonders für E-Mail, Fernzugriff und privilegierte Konten; ungewöhnliche Anmeldungen und Datenabflüsse überwachen. [5]
- Kommunikations- und Geschäftspartner auf kontextbezogene Phishing- und Business-E-Mail-Betrugsversuche (BEC) vorbereiten; Zahlungs- oder Kontaktdatenänderungen über einen zweiten, bekannten Kanal bestätigen.
- Netzsegmentierung, privilegierte Zugriffe und Offline-/unveränderbare Backups regelmäßig prüfen – inklusive getesteter Wiederherstellung. Backups reduzieren Ausfallfolgen, verhindern aber keine Veröffentlichung bereits exfiltrierter Daten. [5]
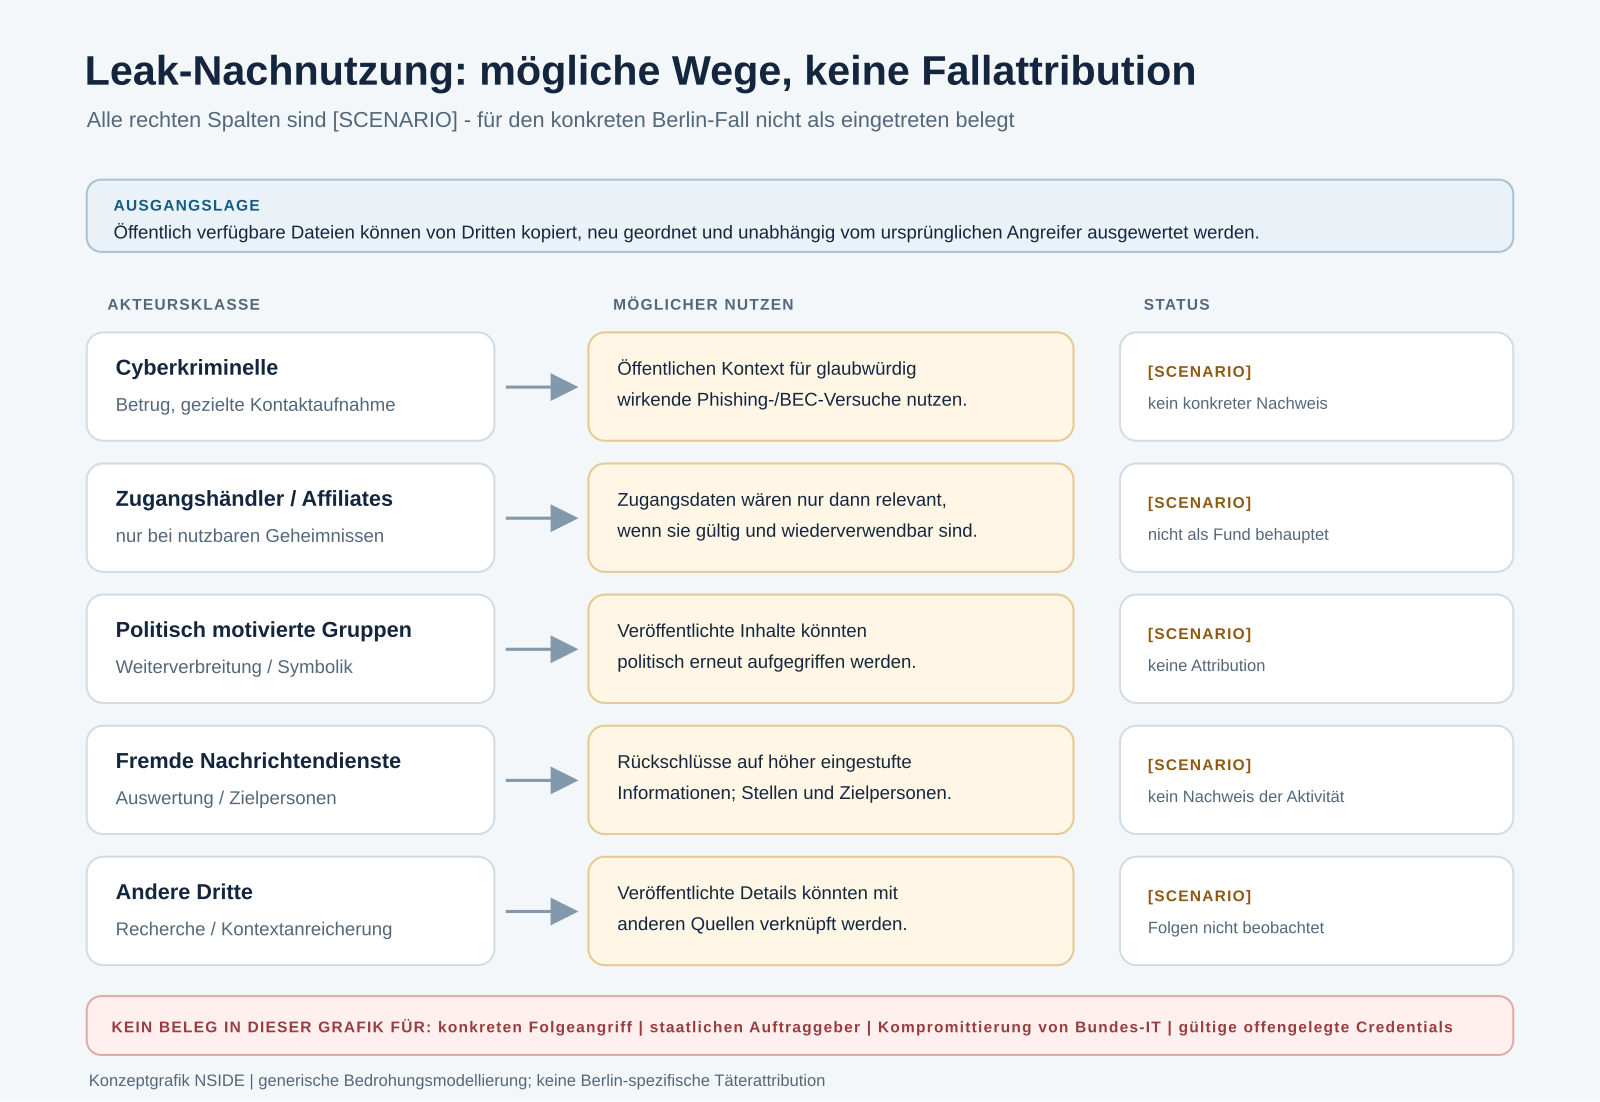
Abbildung 5 – Nachnutzungsszenarien. Mögliche Nachnutzungswege durch Cyberkriminelle, Zugangshändler, politisch motivierte Gruppen, fremde Nachrichtendienste und andere Dritte – ausdrücklich Szenarien, kein Nachweis einer konkreten Folgeoperation im Berlin-Fall.
Ausgewählte Quellen
- [1] Land Berlin, Cyberangriff auf das Landesnetz, offizielle FAQ, Stand 29.09.2026: https://www.berlin.de/cyberangriff/
- [2] The Hacker News, „Berlin Refuses to Pay Hackers Who Stole Data From the City’s State Network“, 28.08.2026: https://thehackernews.com/2026/08/berlin-refuses-to-pay-hackers-who-stole.html
- [3] Der Tagesspiegel, Umfang der veröffentlichten Dateien, 04.09.2026: https://www.tagesspiegel.de/berlin/countdown-nach-hackerangriff-auf-berlin-am-freitagnachmittag-konnten-die-angreifer-sogar-daten-von-burgern-veroffentlichen-16015921.html
- [4] Berliner Beauftragte für Datenschutz und Informationsfreiheit, Hinweise zum Cyberangriff, Stand 11.09.2026: https://www.datenschutz-berlin.de/datenschutz/hackerangriff-auf-berlin
- [5] CISA/FBI/MS-ISAC, #StopRansomware: Rhysida Ransomware, ursprüngliches Advisory 2023, aktualisiert 30.04.2025: https://www.cisa.gov/news-events/cybersecurity-advisories/aa23-319a
- [6] Der Tagesspiegel, Senatskommunikation zu Russland-Bezügen, 01.09.2026: https://www.tagesspiegel.de/berlin/it-sicherheit-16005561.html
- [7] Deutscher Bundestag, Grundgesetz, Art. 22: https://www.bundestag.de/parlament/aufgaben/rechtsgrundlagen/grundgesetz
- [8] Bundesregierung, Geschichte und Aufgaben des Bundespresseamts, Regierungssitz Berlin: https://www.bundesregierung.de/breg-de/bundesregierung/bundespresseamt/geschichte-und-aufgaben-454036
- [9] BSI, Active crime groups in Germany (Gruppeneinordnung, recherchiert 10.10.2026): https://www.bsi.bund.de/EN/Themen/Unternehmen-und-Organisationen/Cyber-Sicherheitslage/Analysen-und-Prognosen/Threat-Intelligence/Aktive-Crime-Gruppen/aktive-crime-gruppen.html
- [10] Berlin.de/dpa, „Hackerangriff auf Landesnetz: Arbeit mit Hochdruck an Lösungen“, 19.08.2026: https://www.berlin.de/aktuelles/10581479-958090-hackerangriff-auf-landesnetz-arbeit-mit-.html
- [11] Berliner Senatskanzlei, Pressemitteilung vom 28.08.2026, „Das Land Berlin lässt sich nicht erpressen“: https://www.berlin.de/rbmskzl/aktuelles/pressemitteilungen/2026/pressemitteilung.1708208.php
- [12] Anadolu Agency (unter Berufung auf Der Spiegel), „Hackers demand $2.3M in ransom after breaching Berlin government network“, August 2026: https://www.aa.com.tr/en/europe/hackers-demand-23m-in-ransom-after-breaching-berlin-government-network/4041001
- [13] BSI erklärt ersten Angriffsvektor auf Berliner Behörden, 07.09.2026: https://www.heise.de/news/BSI-erklaert-ersten-Angriffsvektor-auf-Berliner-Behoerden-11444072.html
- [14] Der Spiegel, Hackergruppe Rhysida veröffentlicht weiteres Datenpaket aus Berliner Leak, 06.09.2026: https://www.spiegel.de/panorama/cyberangriff-in-berlin-hacker-veroeffentlichen-weiteres-datenpaket-a-6a57e12c-0038-4d95-b867-ca94795fa080
Hinweis: Dieser Beitrag gibt den öffentlichen Quellenstand vom 13.10.2026 wieder. Bewertungen sind als [ASSESSED] oder [SCENARIO] gekennzeichnet.